摘要
我们设计了基于大规模分布式机器学习和深度学习的CTR&CVR预估模型架构。本文大致分为两个部分:内容投放和内容生成。其中内容投放,即信息流投放,应用于搜索/推荐/广告的内容流量投放平台,完成内容分发投放。另一部分为内容生成,基于AIGC多模态技术的生成式大模型。文章的第一部分为整体工作介绍。第二部分对该领域此前工业界相关工作和目前最新进展做了介绍。第三部分主要为工程基础架构,涵盖离线数仓和近线的实时数仓、分布式数据库、分布式模型训练框架、线上微服务架构,以及性能优化方法、和最终优化后的系统性能指标。第四部分为算法原理设计,针对当前业界主流模型做了改进和综合应用,并提出了一种新的算法模型。第五部分对算法模型进行实验对比验证,同时记录了算法实验在各不同实测数据集上的表现。第六部分,针对以上工作,我们提出了一种大规模分布式机器学习和深度学习模型训练框架,应用于多集群并行训练,提高模型训练效率和资源利用率。第七部分简要介绍了最后的算法工作结论,目前的算法设计具有优于主流模型水平的效果。
一、概述
近年来,在互联网toC用户领域的信息流投放技术日趋完善,基于机器学习和深度学习的搜索、推荐、广告技术,已经发展成为成熟的产业链生态体系,为投放平台提供持续的业务增长。同时随着互联网信息技术的普及,行业逐渐从最初的爆发式用户增长转变为深耕专精领域的存量用户挖掘。与此同时,针对传统行业的toB端商家的技术应用也开始逐步展现出其可能广阔的应用空间。
我们的工作主要是:首先,基于机器学习和深度学习的搜索/推荐/广告的流量投放平台,完成内容信息分发与投放。主要基于大数据技术和个性化内容推荐,包含离线、近线、在线服务等不同系统,通过针对性的流量分发到不同用户,可以针对性地提高用户的点击率和活跃度,提升用户在平台上的留存,同时个性化推荐技术经过特定优化也提升了用户的转化率。第二,内容生成部分。在内容信息流分发投放的同时,由于召回内容物料数量有限,均为人工获取真实视频录像或直播内容,内容生产效率过低,导致大量用户在丰富的行为场景下,仍得不到有效和兴趣内容推荐,为此我们设计了一种内容生成算法,集成到模型中,利用整合图像、视频、语音、文本的AIGC多模态技术,基于大模型训练的生成式大模型,摆脱了传统监督学习的人工标注视频数据,省去了大量人工操作步骤,使投放内容变得更加丰富,给用户更好的个性化和多元化体验,提升了用户留存,同时增加了平台的营收。
此外,我们提出了一种新的分布式模型训练框架,以满足在给定数据量和既定大流量下的实时模型训练和更新,该分布式并行模型计算框架可以更高效地完成模型训练,解决现有算法的效率瓶颈,且具有更好的扩展性和普适性。我们前后上线6版本实验并迭代,并完成全量迭代替换,目前CTR和CVR已经追平人工组,通过补充一些全域兜底逻辑,覆盖了不同种类用户,包含新用户/活跃用户/非活跃用户/预流失用户。实现全方位的点击率和转化率提升。
最后我们把这一系列算法工作整合到计算平台中,形成了机器学习平台和深度学习平台,为后续的业务开发作为基础设施,使后续的开发能够更好、更快地观测和迭代实验效果。同时为了解决大流量下的大规模分布式模型训练问题,我们为模型训练过程中的数据并行和模型并行做了详细的拆分和升级。
二、相关工作
YouTube-DNN,对于视频信息流推荐,其召回部分采用多分类模型,优化目标为下一个推荐视频,负样本为曝光但未完播视频,权重为视频播放时长,相当于给正样本加权,该权重会直接作用到损失函数中,即交叉熵。模型训练标签为视频id,是一个百万级别的多分类模型训练任务。输入特征共计1000维左右,包括:用户看过的视频video-id的embedding,约200维;用户搜索词token-id的embedding,约200维;用户行为和属性等单边特征,约300维;物料单边特征,包括视频流行度和视频新鲜度,约300维,后期通过对样本进行负采样处理,使模型训练加速100倍。整体模型仍然采用离线计算物品特征embedding,线上实时计算用户行为特征embedding以获得相似向量召回。具体地,采用相似度计算,即最近邻搜索方法计算向量cosine,而后检索,按排序分数截断topN召回item集合。排序部分的精排模型采用的打分模型为二分类,正样本为曝光和点击的视频,训练权重为视频播放时长。
双塔DSSM,利用计算语义相似度的深度学习模型,解决传统关键词匹配模型无法捕捉语义相似性的问题。核心思想是将查询语句query和文档doc映射到同一低维语义空间,通过余弦相似度计算两者向量距离,从而评估语义匹配程度。模型结构采用双塔结构,包含用户塔和物料塔,分别通过深度神经网络将查询和文档转换为低维向量,两侧塔的输出维度需一致,以确保特征对齐。具体的应用场景,主要应用于搜索场景的召回阶段,例如搜索引擎中匹配查询与文档的语义相似度,也用户在推荐系统中预测用户对物料的兴趣匹配程度,其优势在于处理语言细微差异性,并可扩展至其他相似度计算场景。其具有的优点是可以有效处理语义层面的匹配,生成句子嵌入向量用于相似度预测。同时,双塔结构无法捕捉两侧特征交互信息,可能影响精准度。并且,模型训练需要依赖大量点击或曝光日志数据。
深度兴趣网络DIN,主要用于解决传统推荐系统无法有效捕捉用户多样化兴趣的问题。其核心是通过注意力机制动态生成用户兴趣表示,提升推荐精准度。核心思想是通过注意力机制为不同商品分配权重,动态生成用户兴趣表示。与传统模型用固定向量表示用户不同,DIN根据用户历史行为和候选商品的相关性动态调整兴趣权重,例如用户浏览过某个商品,对该商品相关商品的兴趣度更高。整体模型结构分为:嵌入层,将用户历史行为和候选商品转化为低维向量。注意力计算层,通过元素剪切、拼接等操作生成差值向量,输入全连接层后通过softmax函数得到注意力得分。兴趣交互层,结合用户历史行为和当前商品的特征,通过多层感知机(MLP)提取潜在特征。其优点可以概括为以下两个:第一,动态兴趣表达。根据不同商品动态调整用户兴趣权重,避免单一固定向量限制。第二,应用场景广泛,适用于电商、新闻、音乐等领域,尤其在电商场景中通过用户历史行为优化推荐效果,例如浏览、购买记录等。其在大规模广告平台等实际场景中取得了显著效果,成为工业界主流推荐模型之一。
点击转化预估模型ESMM,多任务学习模型,但主要集中在点击率(CTR)和转化率(CVR)预估方面,主要用于解决推荐系统中点击后转化率(CVR)预估面临的样本选择偏差(SSB)和数据稀疏(DS)问题。其核心思路是,通过在用户整个行为序列空间建模,共享特征表达,联合训练点击率CTR和点击后转化率CTCVR两个任务。其核心在于通过多任务协同训练,缓解数据稀疏问题,并消除样本选择偏差带来的影响。其使用场景多为电商、信息检索、在线广告等需要精准预估转化率(CVR)的场景。例如在电商平台中,通过预估商品被点击后的购买概率(CVR),优化商品推荐排序,最大化交易总额(GMV)。该模型的主要优势主要为三个:第一,解决样本选择偏差问题(SSB),传统CVR模型仅用点击样本训练,而ESMM在全样本空间建模,避免训练与实际预测分布不一致的问题。第二,缓解数据稀疏问题(DS),通过共享特征表达,利用未点击样本辅助训练CVR模型,减少数据稀疏问题。第三,多任务协同,同时优化CTR和CTCVR,提升模型泛化能力。
多专家模型MMoE,通用多任务学习模型,通过引入混合专家结构,解决传统多任务模型在任务差异较大时,效果不佳的问题。其核心思想是利用门控网络为不同任务分配权重,从而灵活组合底层共享特征。MMoE由三部分组成:共享底层,提取输入数据的通用特征;专家层,包含多个专家网络(MoE),每个专家处理不同维度特征;门控网络,为每个任务生成分配策略,根据任务需求动态调整底层特征的利用率。其模型的核心优势在于:第一,避免参数膨胀,通过门控网络动态组合共享特征,无需增加额外参数,即可适应不同任务;第二,灵活捕捉差异,显示学习任务间的关联性与差异性,提升各任务的学习效率;第三,使用场景广泛,适用于推荐系统,用于预估点击率和转化率,适用于搜索引擎,用于预估相关性和满意度等,同时更泛用于多目标优化场景,对于无法确定或者动态变换的线性、非线性多目标组合具有良好的普适性。与传统多任务学习模型的对比,比如共享底层结构,MMoE强制所有任务共享底层参数,当任务差异较大时,易导致过拟合或性能下降。MMoE通过门控机制缓解了这一问题,但需要更多数据训练。
分布式训练框架DeepSpeed,深度学习优化库,专注于提升大规模模型训练效率和可扩展性,其通过多项核心技术降低显存占用、加速训练过程,并与PyTorch等主流框架无缝集成,支持分布式训练和千亿级参数模型训练。其核心功能主要是:第一,显存优化,通过ZeRO系列技术分片模型状态到多GPU,实现显存占用随GPU数量线性下降,支持更大模型训练。第二,通信优化,1-bit Adam算法通过压缩通信数据,减少5倍通信量,提升训练效率。第三,混合精度训练,自动切换半精度浮点数(FP16)与全精度浮点数(FP32),平衡精度与计算效率。其框架具备良好的兼容性,适配MPI、MCCL等多种通信策略,兼容消费级显卡(如T4、3090)云端服务器显卡;同时具备良好的扩展性,支持从单机多卡到千卡级集群的分布式训练,适用于语言模型、图像处理等场景。目前已广泛应用于GPT-3、Turing-NLG等超大规模语言模型训练,并持续迭代优化。
三、基础架构
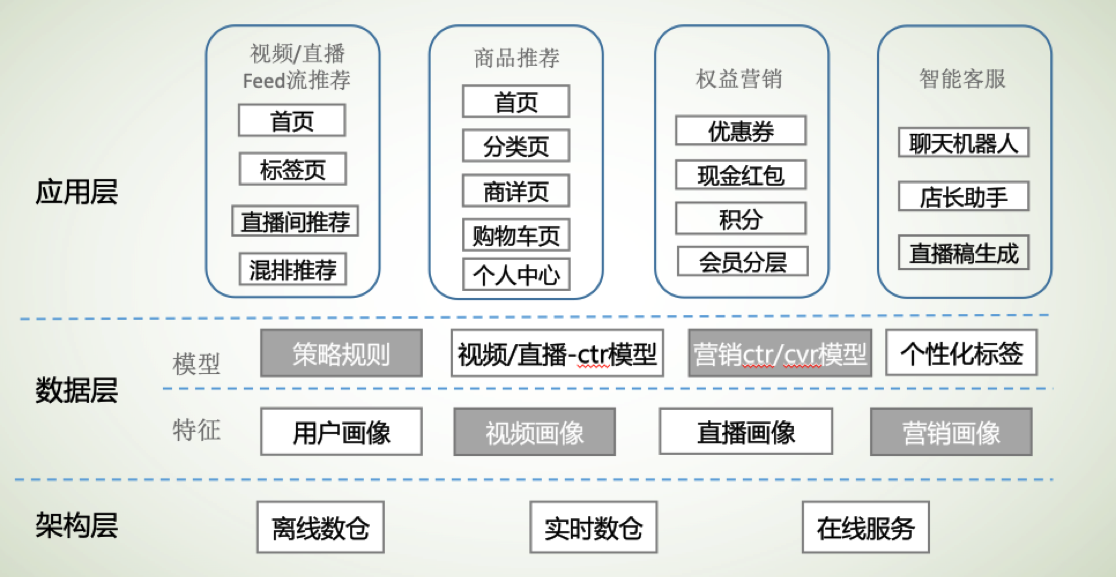
3.1.离线架构
埋点监控日志中,用户所有行为数据被记录到原始日志里,按分块大小存储到线上服务的数据库中。通过解析不同时间粒度的数据到数据仓库,保留了用户行为动作的原始形态。基于日志记录经过Kafka消息队列,可以缓冲记录用户实时信息流,然后通过Flume分布式日志记录框架抓取不同线上服务器的用户动作行为,存储到离线HDFS中。需确保不同分布式机器上的时间戳顺序,做到同步记录,最终汇总到离线数据池中。数据依托于一般的持久化存储介质,结构化数据流入基于MySQL的PolarDB或其他存储介质,非结构化数据一般流入MongoDB以保留原始数据特征形态。从数据库提取出来的数据,经过标准格式化处理后进入Hive,以结构化形态存储,通常离线数据仓库以T+1时间频率更新全体数据,离线数据仓库依据数据不同存储形态,自下而上分别分为五层:操作数据层(ODS层),存储原始数据,结构与源系统基本一致,作为数据准备区;数据仓库明细层(DWD层),构建最细粒度的明细数据表,结合业务过程特点设计宽表,关联维度模型主键与事实表外键;数据仓库汇总层(DWS层),基于主题对象构建公共指标汇总表,采用宽表化手段统计口径,提供上层应用公共指标支持;维度层(DIM层),以维度建模为核心,定义维度属性及关联逻辑,构建雪花模型的维度表;应用数据存储层(ADS层),存储最终应用数据,导出至OLAP、RDS等数据库共业务使用。
离线特征工程,主要涉及离线整体pipeline处理,下沉到特征中台。将原始数据转换为机器学习模型输入,主要通过批数据处理实现,适用于数据一致性和离线计算的场景。一般地,特征工程主要部分有:第一,数据收集与清洗,整合用户行为、物品属性、交叉行为数据等离线数据,处理缺失值和异常数据;第二,特征构造,通过用户画像、物品分类等方式生成新特征,如用户最近活跃时间、用户点击浏览行为、用户基本属性、物料类别分布;第三,特征处理,进行数据离散化、归一化、池化等操作,提升数据质量,比如将连续型特征转换为分段函数;第四,评估优化,通过离线模型验证特征有效性,筛选出对例如点击率和转化率等业务指标提升的显著特征。离线特征工程处理周期较长,一般以天或小时为单位,侧重批量修正和长期效果优化。在一般应用场景(例如电商推荐系统),离线特征常用于修改订单延迟反馈、计算用户长期兴趣偏好。
离线集群,处理海量历史数据的分布式计算系统。基于Hadoop/Hive构建,通过批量处理方式完成数据清洗、聚合和分析任务,支持大规模数据存储和复杂计算,承载功能数据存储、数据处理、数据分析等功能。数据采用分布式存储(如HDFS)分块存储数据,确保高可用性和可靠性;通过MapReduce框架批量处理数据,进行数据清洗;利用Spark计算框架进行统计分析和机器学习模型训练。整体技术架构遵循几个原则,离线数仓分层设计、通过Yarn等组件进行资源调度,动态分配CPU和内存资源,支持弹性扩容;通常情况下,离线集群不要求秒级响应,而是通过空闲时间段完成数据处理,降低实时性要求以换取更高吞吐量和成本优化。
3.2.近线架构
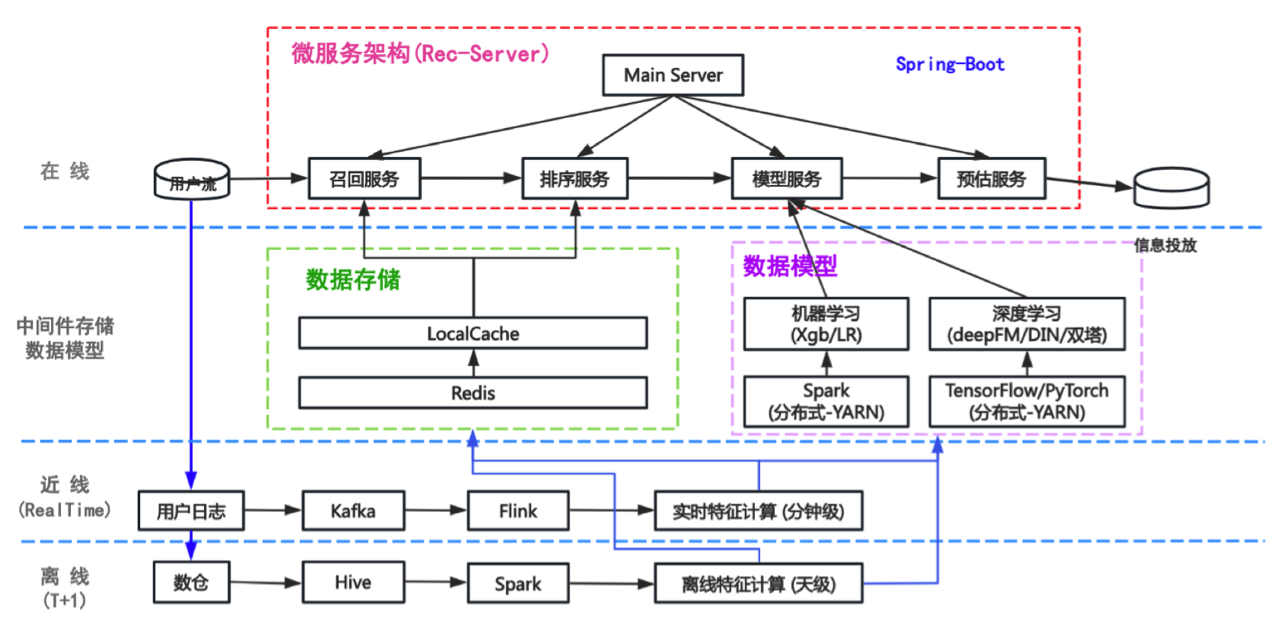
近线分布式集群,实时信息流日志处理,实现数据秒级更新与查询,针对24小时内埋点日志,采用流式特征计算和流式模型,生成近线预估模型,重点作用是补充用户实时行为数据+新注册用户实时检测,时间频率一般为分钟级和秒级。主要特性为分布式事务处理、高并发支撑、数据一致性保障。自下而上分为三层:操作数据存储层(ODS层),存储临时原始数据,一般用Kafka消息队列采集数据,其底层元数据通过zookeeper保存;实时数据仓库核心层(EDW层),实时计算引擎Flink流式处理数据,通常的可以分为批处理和流处理两种方式,最常用的是流处理记录数据,其依托于yarn资源管理执行任务,通过实时读取kafka流数据到hive等数据存储,实现实时数据落盘;应用数据存储(ADS层),面向业务场景的数据视图,支持及时分析和在线数据服务。与传统离线数仓相比,数据得到及时响应的场景会更多,并处理TB级别数据增量更新。
在线特征工程,主要用于近线模型使用,补充用户实时行为特征和实时CTR预估。以离线90天作为基线,然后每天做增量训练,每10-15min收集线上的数据用作模型训练。数据依托flink从kafka读取落到hive,每个批处理时间节点进行结转,同时覆写线上特征权重,在线预估模型采用FTRL,用作增量模型基线,同时优化模型训练速度。对于在线模型,发布周期可缩短至1天、每1h更新一次。
3.3.分布式模型训练
分布式模型训练主要为两个方向拆分:数据并行和模型并行。
(1)数据并行:主要针对python单机版本,训练样本数据分片,主要为训练集的横向拆分,保证单分片的训练样本在一定数量范围内,使得训练集数据和训练过程生成的model.DataFrame小于最大内存。通常情况下,结合特征维度,使得训练集矩阵不会超过内存大小,最终将分片预测结果汇总拼接,得到最后的模型推理结果。因为python版本模型训练,仍属于单机模型,其依托于pandas.DataFrame基本矩阵结构,每次训练向集群提交任务时,会将全部数据加载到计算容器中,该项基本数据单元不能被拆分,故最小数据块大小取决于训练集数据分片后的大小。
(2)模型并行,对python单机版模型训练做了改进,依据现有基于python的并行矩阵dask、和并行库Ray,可以直接在单机节点上进行并行计算;另外,直接依赖分布式计算框架,分布式spark-xgb,依据业界已有的分布式计算框架spark的机器学习库可在部分适当的基础上,对已有常见的机器学习模型直接进行分布式计算,基本机理是通过驱动Driver节点向分布式Worker子节点提交job任务以直接分发到各计算节点上完成计算。该方法在一定流量程度范围内的确能有效提升模型训练的计算效率,但受限于给定计算集群节点数、计算服务器节点内存最大值、服务器主频等基本参数。在一些对实时计算要求不高的业务场景下,的确能有效缓解计算瓶颈问题,且受限于既定算法模型库的数量。我们针对spark基础数据单元DataFrame部分做了改进,同时优化了调度方案。
3.4.在线服务架构
数据存储存放检索用户id和召回内容结果集合,结构化数据存放于MySQL,但通常以kv形式存放于Redis,以实现高速读写、缓存数据、会话管理,其基于内存数据结构作为存储系统,原子性操作保证了数据的一致性,支持快照和追加文件两种持久化方式,确保数据安全性,同时可以实现高可用。同时在需要快速全文检索场景引入了ES检索,应用于多种组合条件查询的场景,分布式架构支持横向扩展,多节点处理海量数据,同时实现了近实时搜索,数据写入后立即可检索,且每个字段均可索引。数据库与在线服务之间增加localCache,数据存放于内存,可以本地快速访问缓存数据,提高程序效率,减少对后端数据元访问频率,降低后端负载,提高整体性能。为提升系统整体吞吐量,单机扩容到分布式和多源数据库组合,形成分布式数据库集群,有效缓解查询负载压力,整体QPS提升300%。
分布式线上微服务:信息流投放以在线接口调取不同数据源的召回数据,进行后加工处理,总体各步骤相互独立,仅有接口依赖,涉及到主要部分为:召回、排序、模型、预估,应用程序拆分为多个小型、自治的服务单元,单独部署和维护,之间通过轻量级通信接口交换数据,每个服务聚焦单一业务功能,拥有独立数据库和代码,支持松耦合架构和弹性扩展。整体保证数据一致性,各服务之间技术栈独立单独存在。信息流投放涵盖多业务线的接口,如视频/直播,线上商城,广告投放,权益活动投放。
如图2所示,用户在线请求会通过解析到达数据库匹配响应特征对应的召回源,从召回服务提取对应的召回数据,然后经过排序服务,对所有召回源集合依据排名分数进行排名,然后经过模型服务提取对应的模型计算分数,最后进入预估服务,获得在线CTR和CVR的预估分数的物料排序结果,最后将结果呈现给用户。所有在线微服务都从缓存或者数据库里获取数据,以及模型服务从模型结果里获取事先更新好的模型结果。数据库或模型的数据来源为离线数仓和实时数仓,而这两部分的数仓的数据来源为线上的用户行为日志,实时或者按天结转到日志记录系统中,然后被加工为数仓的离线表。从而形成线上和线下的闭环通路。
压测,此处采用Wrk对在线服务进行压力测试,其参数分别为:t为模拟线程数,c为模拟连接数,t为超时时间timeout,d为测试时间,例如‘wrk -t4 -c2000 -d30s -T5s’表示4个线程,2000个连接数,在30s内,压测时间间隔5s,其中latency参数查看响应时间的分布情况。在测试结果中,Latency为响应时间,Req/Sec(QPS)为每个线程每秒钟的完成请求数,Avg反映平均大小,以及Max最大值,Stdev标准差表示正负一个标准差占比,标准差如果太大,说明样本本身离散程度比较高. 有可能系统性能波动很大。模拟测试的线程数大概为机器核数的2-4倍,不会过多,否则会因为线程切换过多造成效率降低,wrk不是使用每个连接一个线程的模型,而是通过异步网络IO提升并发量。
| 数据库 | t4-C20 | t4-C30 | t4-C40 |
|---|---|---|---|
| Redis | TTS: 589.68ms Requests/sec: 56.97 |
TTS: 540.65ms Requests/sec: 57.80 |
TTS: 794.92ms Requests/sec: 57.69 |
| ES | TTS: 529.72ms Requests/sec: 61.86 |
TTS: 701.66ms Requests/sec: 57.64 |
TTS: 2.00s Requests/sec: 226.19 |
监控,接入Prometheus服务对线上服务器重要接口进行监控日志分析,用控制面板Grafana展示监控结果,以保证对数据结果的及时追踪。
(1)服务监控:接口和重要流量位;
(2)离线数据和调度任务监控:数据正确性、准确性;
(3)日志滚动切分,日志埋点落盘,基于Kafka,Flume,Hdfs;
(4)服务架构和运维:监控报警,服务容灾,高可用;
(5)数据看板:开发各流量位的业务指标监测,基于Superset。
3.5.性能优化
我们对服务性能各部分进行了优化:
(1)算子优化:召回、排序、模型、预估,微服务拆分优化;
(2)服务扩容:采用Nginx分流和Zookeeper负载均衡,同时实现AB分流配置,每个特定用户请求会被依据id号分配到不同流量实验上,以作结果对比分析;服务增加了Jdk性能分析,利用jvisualvm,jstack,jstat,包含代码块、程序堆栈、应用程序分块占用时间,分别优化程序执行效率和内存占用空间;
(3)代码质量:执行时间优化,内存占用优化,算子模块解耦优化,算子指令集优化;
(4)数据查询耗时:查询IO优化、数据库优化、分布式优化、索引优化;
(5)缓存命中:连接池优化、索引优化。
3.6.工程结果
经过优化后的线上服务,系统吞吐量QPS,在未经优化前的单台机器QPS为71,优化后的预发布机器单台机器为136,升级了分布式集群后,预估所有集群吞吐量的总和为136×6=816,总体性能提升提升11.5倍,同时带来了TP99的提升。TTS全链路响应时长从未经优化前的单台机器600~700ms,优化后的单台机器响应时间为100ms以内,总体提升提升7倍。
模型训练方面,最初采用的是python单机版,对训练集数据进行分片,单分片训练时间为1h44min,经过优化后,训练时间缩短为30min,总体训练时间提升300%;而后采用spark-xgb分布式版本,训练时间从30min优化到10min,效率提升300%。
最终优化后的QPS估算,包含在线集群、离线分布式集群、分布式数据库的信息流投放系统,能支撑的用户量已经从小流量300w提升到可以支撑全量1000w+流量,达到全量标准。
四、算法设计
4.1.模型架构变体
对于个性化召回部分,我们改进了模型YouTube-DNN,原模型是多分类模型训练。在当前视频流推荐场景中,我们重新建模的用户的特征包括:用户基本属性、用户浏览,点击,有效点击,转发,评论,点赞,分享,收藏,喜欢,用户地理位置,用户购买力,用户订单商品相关视频,同时加入了负反馈特征,例如取消点赞,取消收藏。视频物料特征包括:视频被点击数,被转发数,被评论数,被点赞数,被分享数,被收藏数,被喜欢数,视频起播率,视频完播率,视频播放时长,视频是否有订单商品标签,视频热门度,视频新鲜度,仍作向量召回,注意区分稀疏特征和稠密特征分别embedding建模。整体多分类训练的标签粒度进行浅层聚类,如下文DHAN改进模型所示。
对于召回匹配部分,我们改进了模型DSSM,离线特征训练,线上向量化相似召回推理和预估。整体依据业务不同分为N塔召回,包括:用户塔、商品塔、文案塔、视频塔。用户多维特征经过embedding后,采用DNN多层神经网络训练,而后映射到低维向量空间;同理,其他物料塔各自特征亦经过embedding后,处理仍为多层神经网络。基于word2vector,稠密特征和稀疏特征这两部分,特征需分开做embedding,分桶后作hash处理,每个特征单独去学习向量。在计算向量相似度时采用筛选计算,减小线上召回计算复杂度,同时保证数据压缩到归一化区间,保证数据一致性。
4.2.兴趣网络变体
用户特征向量的改进,借鉴DIN的思路,用户行为特征向量,增加注意力机制,生成动态兴趣向量。用户最近点击浏览过的物料内容将加权,综合不同特征向量,计算注意力综合评分,输入到后续网络进行模型训练。
由于召回多分类的建模粒度控制是一个比较有争议的部分,其重点需要根据具体业务形态来决定粒度切分范围,对于海量数据样本的情况下,最极值的做法是每个样本为一个学习分类目标,但当样本数量级达到百万级或千万级时,这样的做法显然模型训练计算量过大,在实际工程中并不现实。所以需要建模多分类粒度模型,参考DHAN的做法,多样本学习聚合为M-cid,这个M的数量级是可控的,通常取决与业务复杂度,然后实际召回模型学习的是一个M分类模型。同时样本在聚合M个特征向量之间具有正交性,或最起码要保证弱相关性,这样模型学出来的才能具有更好的分类特性。
4.3.排序算法
排序算法仍采用二分类排序,信息流推荐通常更关注活跃度,即具体化为CTR点击率相关指标、视频播放时长。排序模型部分采用L2R模型排序,对多路召回进行混合排序,考虑召回物料相关度排序分数,视频单边特征为其本身标签属性,检索id相似度,视频在整个排序列表的全局重要度,依据CTR和播放时长优化整体排序列表。
优化改进后,整体采用CTR预估模型排序,我们前后优化了v1,v2,v3等三个版本。Version1直接依据点击或播放进行二分类建模,排序结果在应用上的泛化性相对较弱。Version2迭代优化了样本间划分选择,正负样本并不是全域样本空间,而是取为点击播放和点击未播放,同时大量负样本在进行下采样的时候需注意比率。Version3为全域样本空间抽取多粒度建模,注意粒度之间的弱相关性,最终生成的排序模型具有良好的点击率指标表现。
4.4.多目标预测
信息流投放整体的业务范围仍归属于CTR&CVR建模,一般地业务需要同时优化点击率CTR和转化率CVR,属于多目标同时优化。但通常对于这种业务指标数量较少、指标间具有可被函数表示的线性或非线性关系,可以尝试通过寻找指标间的函数关系,进行优化目标拆分,分别优化单一目标,从而达到对整体目标的最终效果优化。而对于这种特殊场景,尤其对于样本空间的选择,参考了ESMM的思路,在预估CVR的情形前,预估点击率CTR和点击后转化率CTCVR,从而达到对最终的CVR的有效预估,同时需注意用户整个行为序列空间建模的样本选择。
但是当多目标预测的情形变得比较复杂,多数跨域业务场景下,优化业务指标变得不可建模,即不可用简单的线性/非线性、正比/反比关系来描述指标间关系,甚至指标还是随着样本数据动态变化、且相互影响的,此时哪怕通过近似线性表示整体优化目标函数变得尤其困难。需要通用多任务学习模型,借鉴MMoE的思路,实行多专家网络推理,大规模专家并行,直接绕过目标函数的指标关系建模这一问题。对于组合门控网络,多专家系统采用MSE多任务,多专家写入,例如8个门,是不同业务领域专家,每个context模型训练,输出是倒数第二层的结果,注意不同层的转播。多任务学习,专家系统推理。后期增加自适应学习,此时建模播放时长并不是主要的了。
五、实验
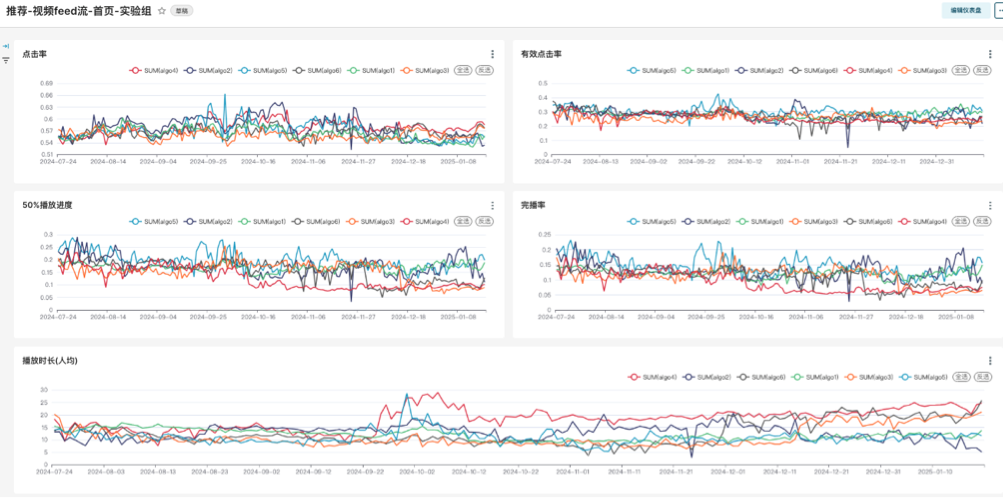
我们对全流量划分为6组流量,分别进行实验,基于PolicyRules, U2i2i, U2u2i, Cid-Pop, Als, CF,以及改进的模型DHAN用于实验。每组分桶实验并不单独是一个完全独立的模型,通常带有兜底策略的组合,但为了作为对照组验证单一改进模型效果,我们尽可能地保证模型的纯度。最终实验分组放量到最大流量,取决于该分组的实验指标表现,指标通常和业务指标相关联,比如CTR点击率大类和CVR转化率大类。
模型实验的评估结果标准依据业务线不同而有细微的差异,对于引流和促进用户活跃度的业务,例如视频和直播,评估指标重点针对CTR点击率大类,细分为:点击率、有效点击率、50%播放进度、完播率、人均播放时长;对于促进成交额和下单转化等业务,评估指标重点针对CVR点击率大类,细分为:用户下单转化率、营收GMV、成本ROI,例如商城的首页,购物车页,订单页面,此外也包括权益类业务,例如红包,优惠券,积分。所有业务最终指向的是用户的留存和转化,所以通常会联合对各指标进行综合优化,即综合指标为CTCVR+ROI/GMV/CVR联合预测。
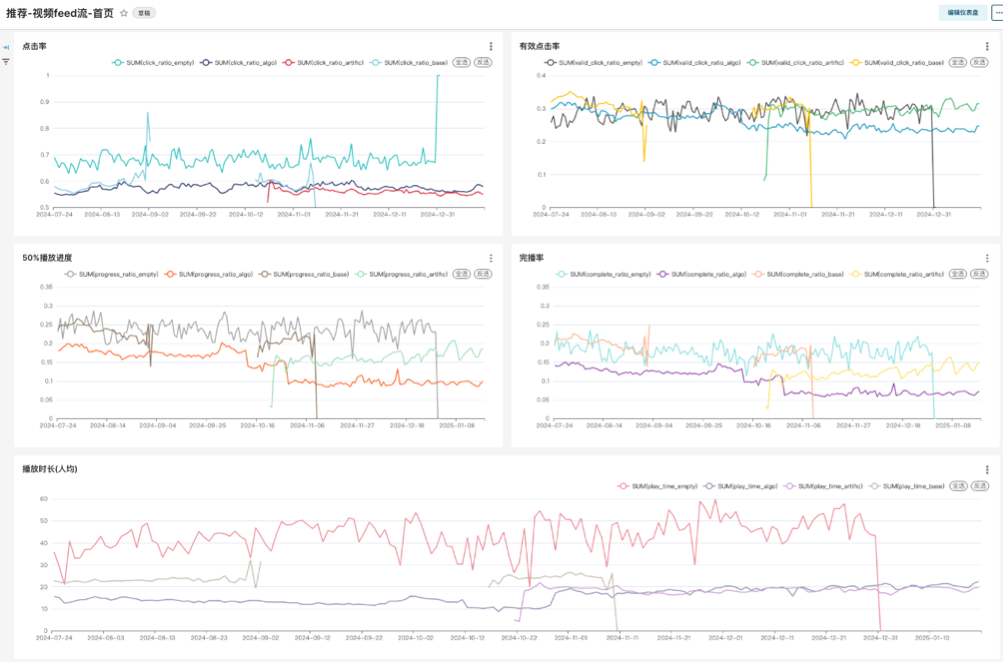
最终指标评测结果,相较于人工规则策略,综合算法指标如下:点击率57.8%,优于人工组54.8%;有效点击率=24.6%,低于人工组31.5%,人均播放时长22~24min,优于人工组19min;整体转化率27%,优于人工组24%。详细粒度的指标数据和趋势图汇总如下表所示:
| 分组 | 点击率 | 有效点击率 | 50%播放率 | 完播率 | 人均播放时长 |
|---|---|---|---|---|---|
| 算法组 | 57.858% | 24.66% | 9.901% | 7.31% | 22.50015 |
| 对照组 | 60.084% | 30.052% | 21.413% | 18.338% | 24.25459 |
| 人工组 | 54.884% | 31.516% | 18.666% | 14.993% | 19.80011 |
| 分组 | 点击率 | 有效点击率 | 50%播放率 | 完播率 | 人均播放时长 |
|---|---|---|---|---|---|
| algo1 | 55.761% | 29.382% | 18.914% | 14.9% | 13.81273 |
| algo2 | 53.378% | 21.57% | 11.019% | 8.836% | 5.1159 |
| algo3 | 57.562% | 23.286% | 8.972% | 6.559% | 21.19954 |
| algo4 | 58.499% | 25.989% | 10.216% | 7.524% | 24.79747 |
| algo5 | 55.244% | 30.546% | 19.771% | 15.518% | 11.66592 |
| algo6 | 57.657% | 27.007% | 12.809% | 9.804% | 25.8069 |
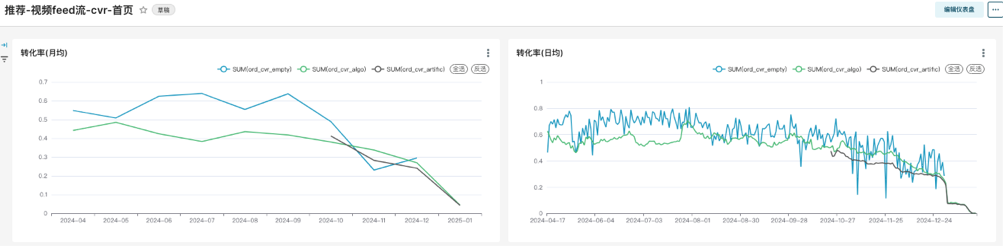
| 分组 | 下单人数 | 总人数 | 转化率 |
|---|---|---|---|
| 算法组 | 8528 | 31611 | 26.98% |
| 人工组 | 39010 | 161963 | 24.09% |
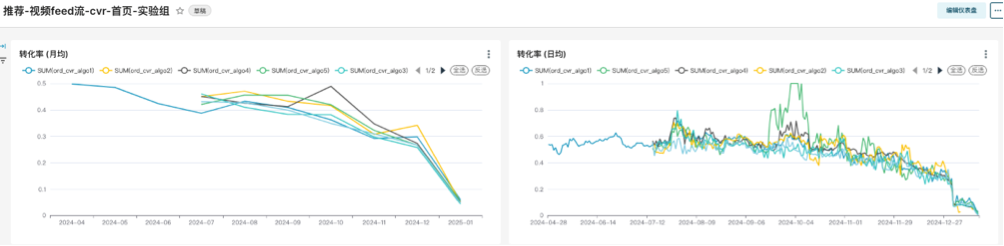
| 分组 | 下单人数 | 总人数 | 转化率 |
|---|---|---|---|
| algo1 | 1214 | 4071 | 29.82% |
| algo2 | 1040 | 3045 | 34.15% |
| algo3 | 265 | 1026 | 25.83% |
| algo4 | 7495 | 27427 | 27.33% |
| algo5 | 208 | 779 | 26.7% |
| algo6 | 400 | 1497 | 26.72% |
从实验结果可以看出,对比baseline模型YouTube-DNN,DSSM,DIN,ESMM,MMoE,列个实验数据对比表格,各项指标综合对比,新算法的指标优于单项基线模型指标。算法组业务指标已经达到替换基线流量标准,且算法系统已通过工程扩容,能支持流量全量标准。
六、大规模分布式机器学习
6.1.框架
(1)数据并行:训练样本数据切片,单分片大小取决于机器内存大小,以及特征维度多少,最大限制是训练矩阵不超过机器总内存;数据并行的过程中,数据分块后,每块数据单独训练为局部模型,最终多个小模型归并为全局模型,在此期间全局模型会回传,以更新每个局部模型。同时可能产生的问题是,小模型本身也比较大,无法加载进单机内存,由此我们引入了模型并行的方式。
(2)模型并行:单机版的python可以利用常见的并行库对pandas.DataFrame改造,比如dask并行库和Ray并行库,直接通过在底层并行基本DataFrame矩阵单元以达到并行的目的。另一种方式是直接基于分布式训练框架spark,一部分通用的机器学习算法(如xgb)可以用库函数实现;而另一部分自定义训练算法则需要手动分区,模型分片后被分发到不同worker节点上,每个worker独立工作,在时间调度上没有依赖关系,可并行执行,最大化利用空闲分片空间。
(3)流水线并行:调度任务pipeline分块并行,将模型的不同层分配到不同设备上,采用微批次处理,提高设备利用率。通过修改调度任务主控流程配置dag或job,在调度器上修改执行方式,可以实现一定数量N的并行块,每个块之间执行分片任务时,相互独立而互不干扰。这种方式可以在多台机器之间以流水线的方式并行执行计算。在大模型或网络带宽被限制的情况下,分布式模型训练速度会变慢,因为大量时间耗费在节点间的网络通信上。流水线并行的方式,目的即为减少通信量,使模型训练和节点间通信同时进行,从而达到较高的CPU/GPU利用率。
6.2.发展阶段
stage1:单集群分布式,训练在单一集群内部,属于同一局域网内,节点之间属于同一网段,彼此间通信不需要加密计算以保护隐私数据。此情形适用于上述大部分技术。
stage2:跨局域网/异地多集群分布式,模型训练在不同局域网的节点,不属于同一网段,需解决通信问题,同时需引入本地数据隐私保护机制;
stage3:超大规模分布式模型训练,异地集群,需引入联邦学习和隐私计算,跨域联合建模训练,同时涉及到算力硬件:CPU/GPU/TPU异构计算,多机多卡,分布式训练;
6.3.业界研究
业界对于大规模分布式机器学习和深度学习,目前主要集中在语言模型训练领域,主要提现在大模型对算力和显存的需求上。一方面是通过分布式集群方式解决,一方面是通过提升硬件能力上。模型所需算力约为大模型参数的数量乘以训练用的token数量的六倍。并且硬件在工业制造领域也存在一定限制,这个限制导致难以突破显存容量。通常硬件利用率与模型参数规模成正相关,更多的训练计算能促使资源利用率提升。Spark数据图思想的提出,即是为了合理分配资源到分布式设备上,NVIDIA等硬件公司也有大规模流水线并行训练相关工作。微软的DeepSpeed框架核心技术在解决大规模分布式训练的显存占用,主要优化在模型计算间碎片化数据资源分配,优化前向和后向计算过程。
七、结论
从工程性能指标、和算法模型实验结果表明,我们设计的新算法优于当前工业界主流基线模型,且能同时适应不同端的数据,包含传统toC用户端,以及toB商家端。且由于系统普遍升级后采用分布式训练,模型训练效率和性能、系统吞吐量等常见评估指标均优于普通单机版。
八、参考文献
[1] Paul Covington, Jay Adams, and Emre Sargin. 2016. Deep neural networks for youtube recommendations. In Proceedings of the 10th ACM Conference on Recommender Systems. ACM, 191-198.
[2] Po-Sen Huang, Xiaodong He, Jianfeng Gao, Li Deng, Alex Acero, Larry Heck. 2013. Learning deep structured semantic models for web search using clickthrough data.
[3] Guorui Zhou, Xiaoqiang Zhu, Chenru Song, Ying Fan, Han Zhu, Xiao Ma, Yanghui Yan, Junqi Jin, Han Li, and Kun Gai. 2018. Deep interest network for click-through rate prediction. In Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining, 1059–1068. ACM.
[4] Guorui Zhou, Na Mou, Ying Fan, Qi Pi, Weijie Bian, Chang Zhou, Xiaoqiang Zhu, and Kun Gai. 2019. Deep interest evolution network for click-through rate prediction. In Proceedings of the AAAI Conference on Artificial Intelligence, Vol. 33. 5941–5948.
[5] Weinan Xu, Hengxu He, Minshi Tan, Yunming Li, Jun Lang, Dongbai Guo. 2020. Deep interest with hierarchical attention network for click-through rate prediction.
[6] Xiao Ma, Liqin Zhao, Guan Huang, Zhi Wang, Zelin Hu, Xiaoqiang Zhu, Kun Gai. 2018. Entire space multi-task model: an effective approach for estimating post-click conversion rate.
[7] Jiaqi Ma, Zhe Zhao, Xinyang Yi, Jilin Chen, Lichan Hong, Ed H. Chi. 2018. Modeling task relationships in multi-task learning with multi-gate mixture-of-experts.
[8] Yang Liu, Tianjian Chen, Qiang Yang. 2018. Secure federated transfer learning.
[9] Kewei Cheng, Tao Fan, Yilun Jin, Yang Liu, Tianjian Chen, Qiang Yang. 2019. SecureBoost: a lossless federated learning framework.
九、附录
我们的工作全部收录在论文和源码里。
源码:https://www.github.com/DianaCody/InfoFlowDelivery
论文:Yan Dai. 2025. CTR-Prediction Model Architecture for Large-Scale Distributed Machine Learning. [pdf]